01
定标准
类别清单、最小框选、遮挡与边界。先定规则,再动手。
00 关于我
我是周依妍,人工智能2601班,ISFP。我的天赋是坐得住、看得细;要补的是结构化表达和长期规划——所以我用标准、报告、时间轴来补。
我不想只做“照着规范标”的人。我想做那个把规范定清楚、替模型守住数据这道关的人。
01 为什么是它
60%
五级技能要求中,数据标注占 60%
这个职业的起点,不是写代码,是标数据。
官方定义
使用智能训练软件,在人工智能产品实际使用过程中进行数据库管理、算法参数设置、人机交互设计、性能测试跟踪及其他辅助作业的人员。
2020 年纳入《中华人民共和国职业分类大典》;2021 年发布国家职业技能标准。
照着规范做,先练执行。
审核、纠错,练判断。
业务分析、智能训练、系统设计。
带团队、定标准、做行业创新。
人工智能训练师的工作内容,已从最初的简单数据标注、效果评估,上升到垂类模型的专业数据处理、模型参数调优、具身智能工作流的设计等。
——《人民日报》2026年3月26日 12版《人工智能训练师成了“香饽饽”》
30%+
上海地区岗位用人需求增长;缺的是“技术+垂直行业”复合型人才。
岗位要求在上移
02 我做了什么
不是生产数据;是我为了练审核找的 100 张图。人物、物体、场景都有。
01
类别清单、最小框选、遮挡与边界。先定规则,再动手。
02
预训练模型先跑一遍,把“可能的答案”铺出来。
03
用 labelme 逐张看:标错、标漏、框歪,一条条挑出来。
04
20 处错误逐条记录,归因、给建议,形成可执行的报告。
我给自己的三条标准
01
只标清单里的类:
清单外:不硬套。
02
先定一个最小尺寸;小于它的目标不单独标,避免碎框。
03
遮挡超过一半不标;框体包含完整可见部分,不留太多背景。
03 我查出了什么
漏检最多;还有类别错、框体偏移。每一个错误,都会被模型学进去。
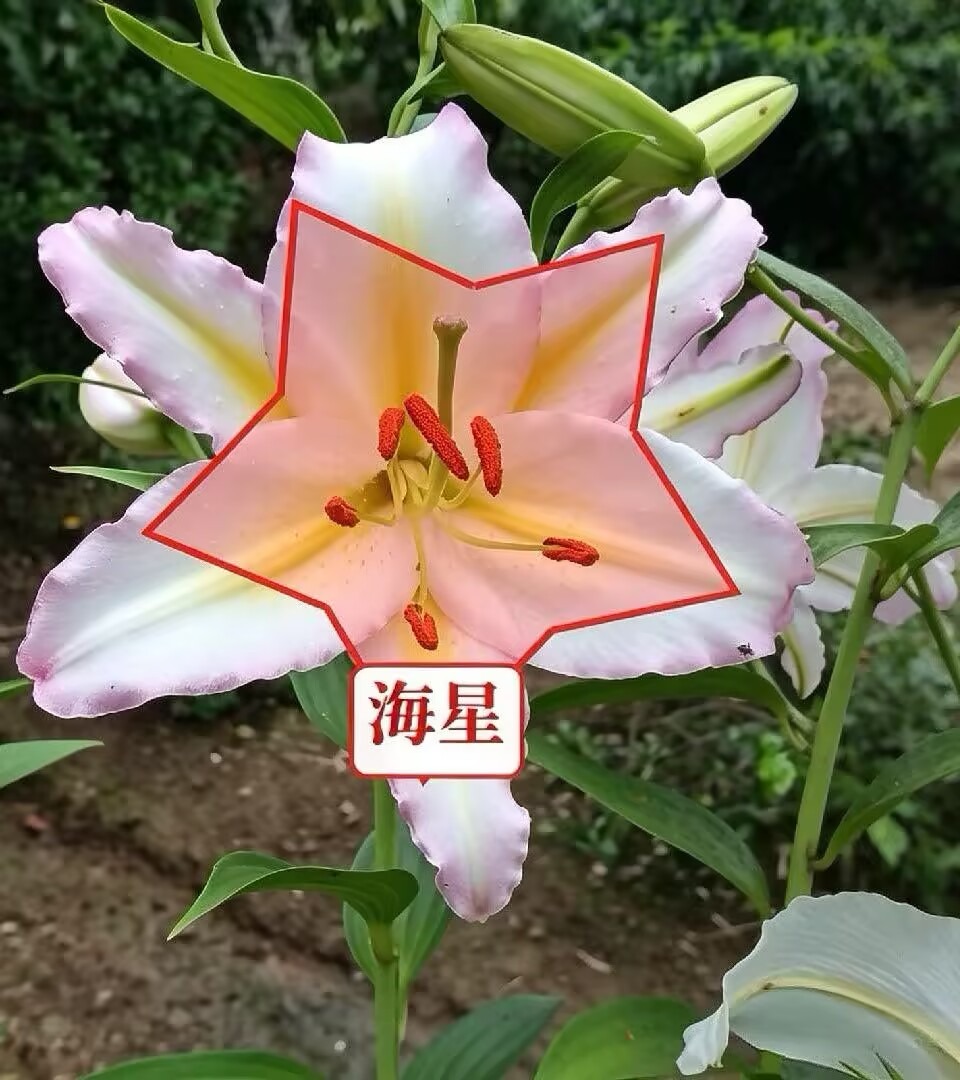 类别错
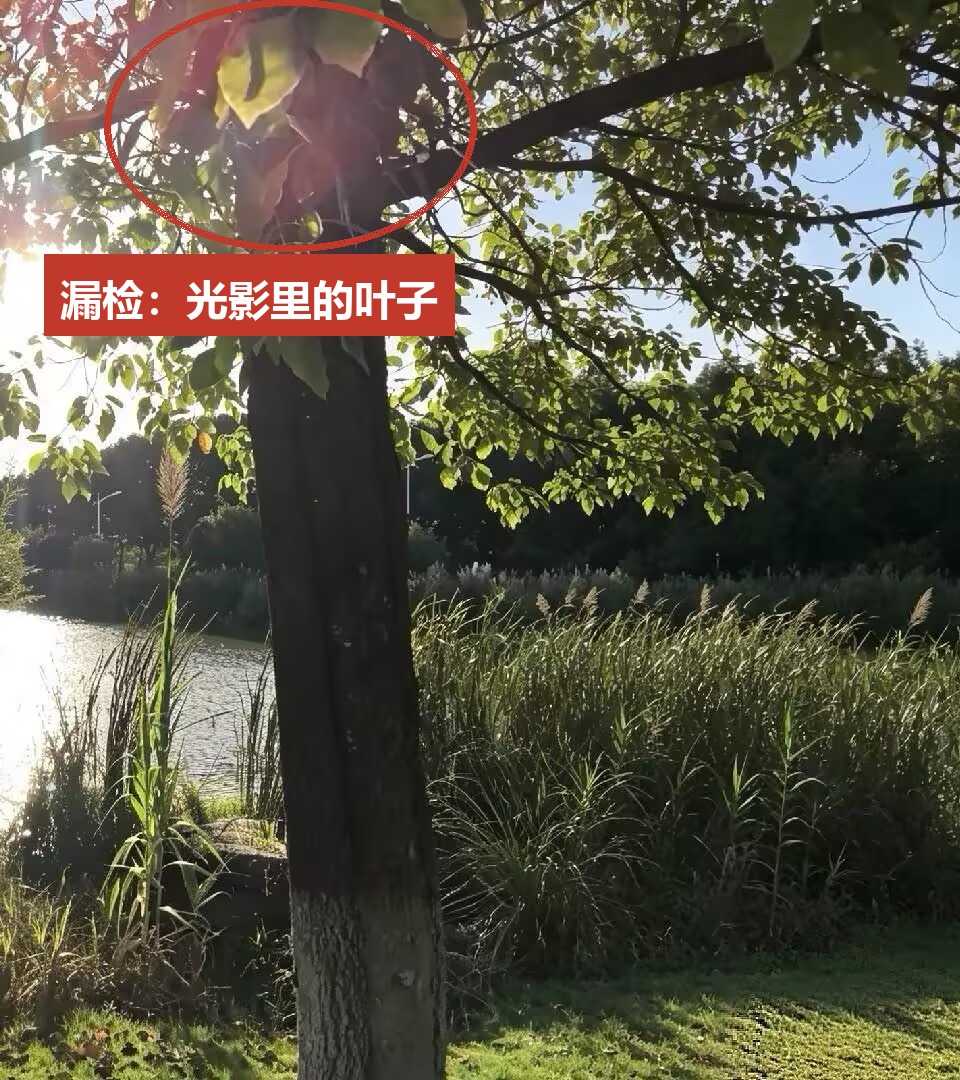 漏检
框体偏移
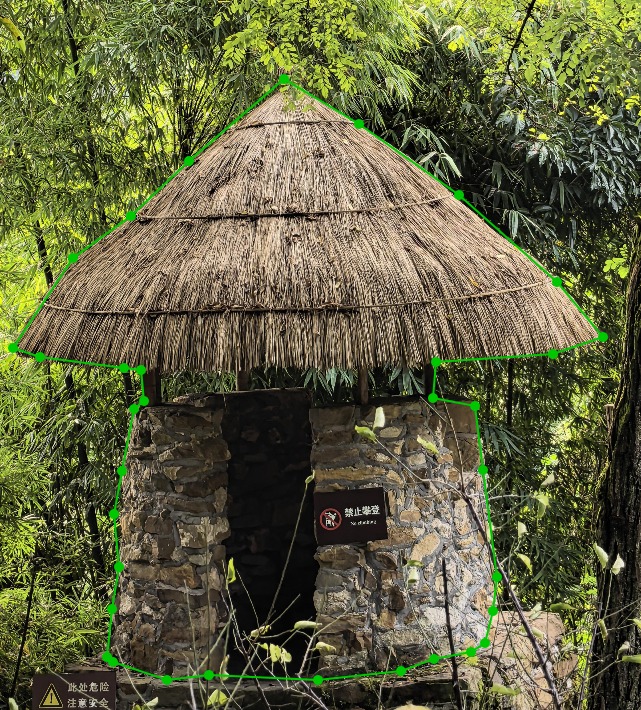
同类错误
纹理和形状都像,模型又抓了“表面”,没抓“场景”。
20 处错误,不是 20 个笑话;是 20 个会被模型学进去的坏习惯。
04 我交付了什么
审核报告 · 节选
| 图片 | 模型标注 | 我的修正 | 类型 |
|---|---|---|---|
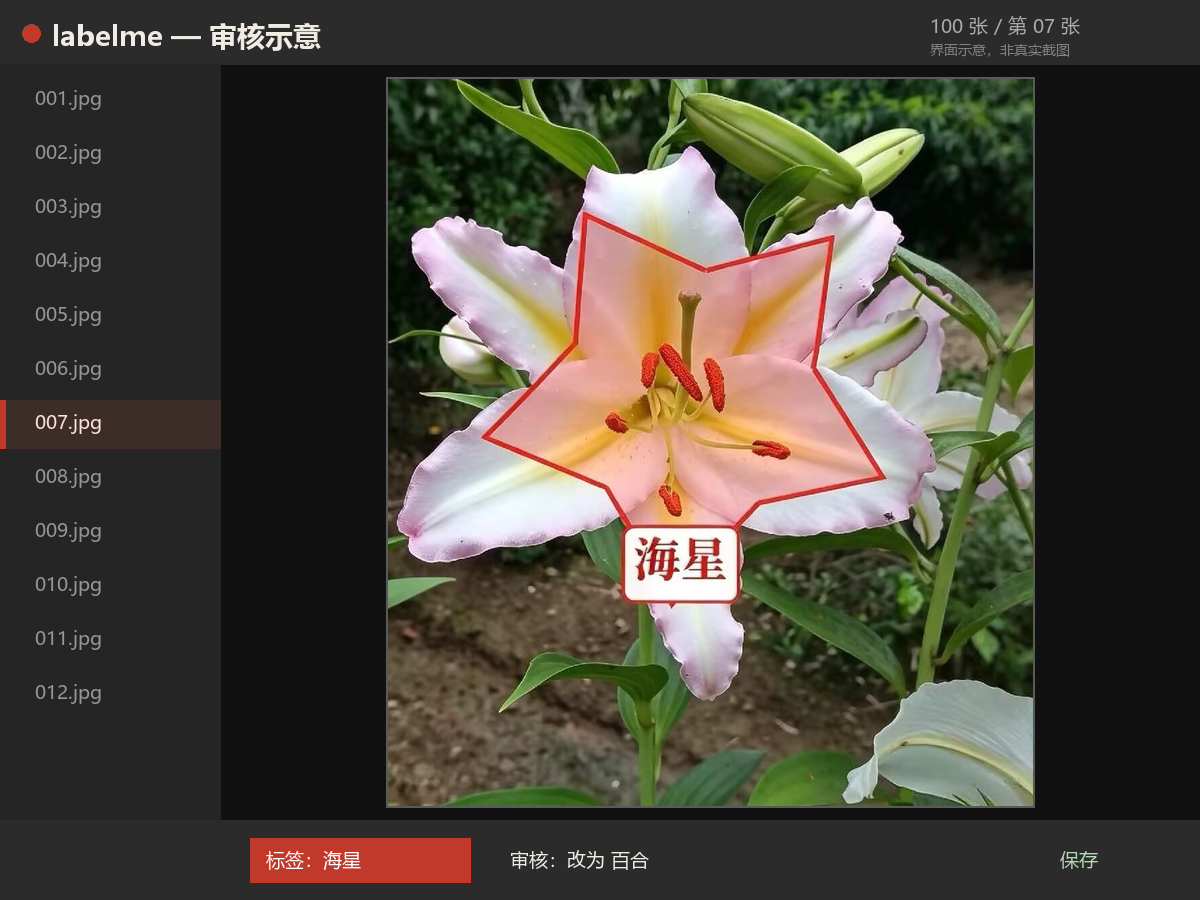
| 百合 | 海星 | 百合 | 类别错 |
| 光影叶子 | 未框出 | 应框出 | 漏检 |
| 蘑菇屋 | 蘑菇 | 蘑菇屋 | 类别错 |
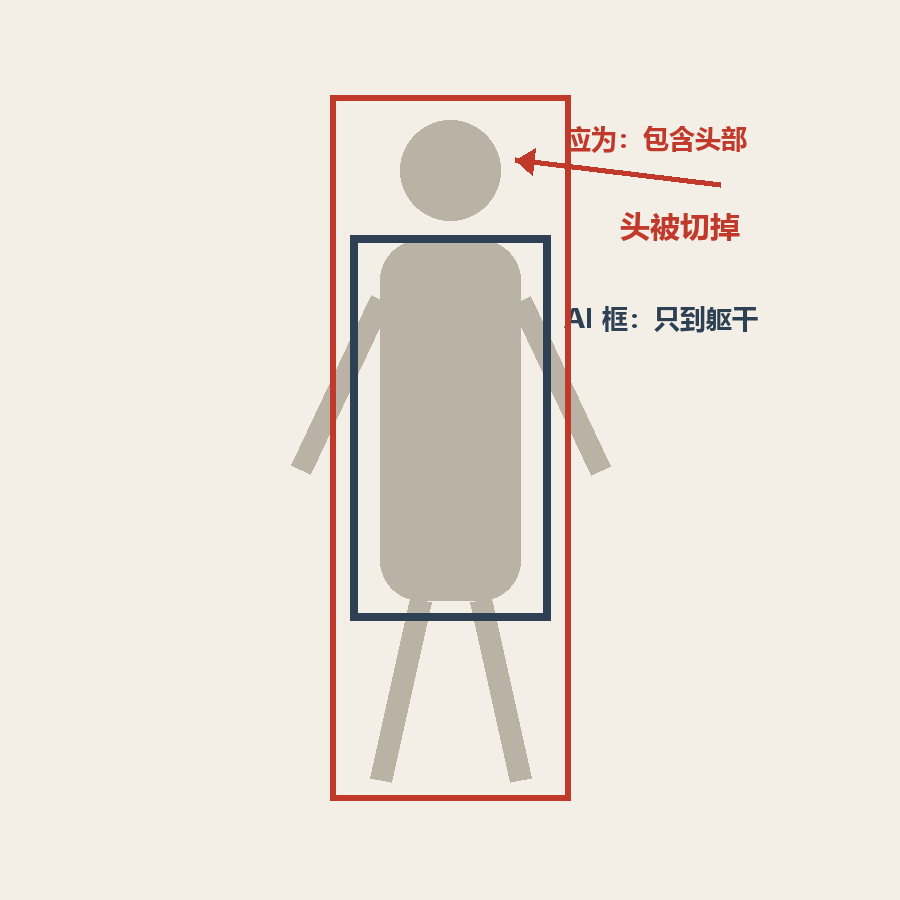
| 人像 | 只框躯干 | 应含头部 | 框体偏移 |
完整记录以原始审核记录为准;这里只放四条节选。
05 我改变了什么
以为
训练师是教 AI 说话的高级工作
发现
大部分时间在跟脏数据较劲
先要坐得住
以为
标注没什么技术含量
发现
规范不一样,模型就是两回事
规范是设计出来的
以为
做 AI 最重要的是写代码
发现
更靠前的一步是判断数据对不对
先判断数据对不对
规范不是执行出来的,是设计出来的。
所以,我想做那个把规范定清楚的人。
06 我要去哪
为什么不直接造模型?学历台阶现在还差一截;我走技能等级通道,同时准备专升本。
下一步:从 100 到 300
审核记录 + 三条标准
跨类别统计 / 标准 v2 / 多人一致性
四级证书(若需逐级,先五级)
专升本
如果主路受阻
触发条件:一年内未取得四级,也未进入质检岗。
换的是岗位,不换的是方向。